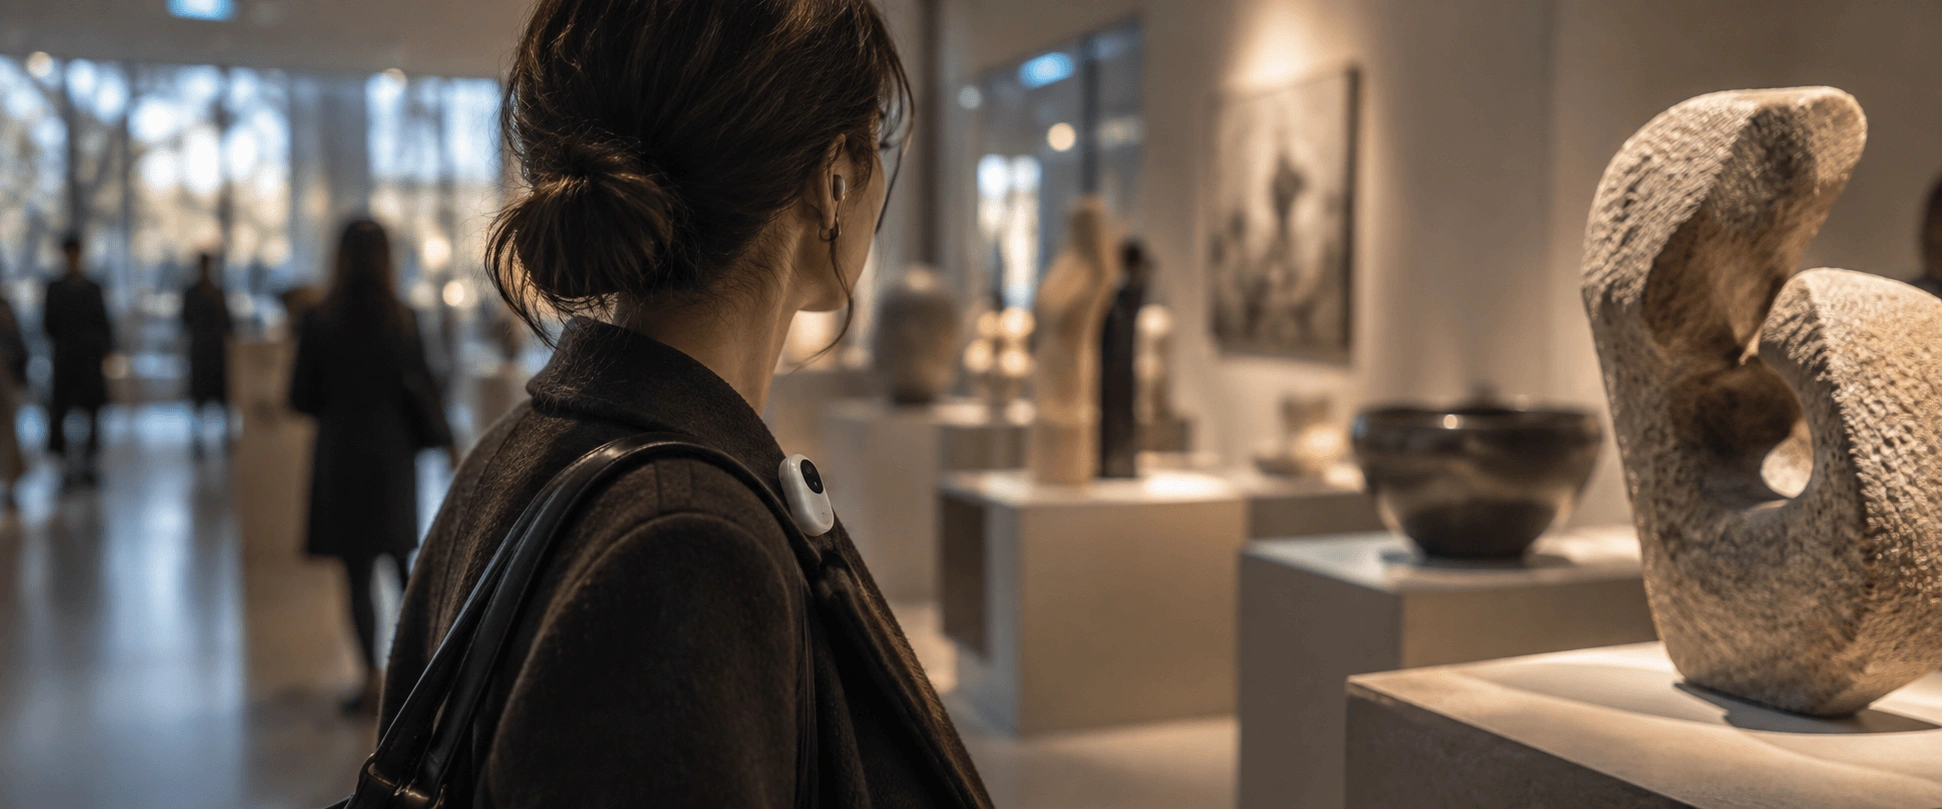
AIが、あなたのそばで、同じ世界を見る。話しかけるAIから、そばにいるAIへ。PERSONAL AI DEVICE CONCEPT
生成AIを使うたびにスマートフォンを取り出し、画面を開き、状況を説明する。その前提そのものを見直しました。カメラ、マイク、通信、スマートフォン、マルチモーダルAIを組み合わせ、身につけたまま、目の前の状況をそのままAIへ渡せる、小型パーソナルAIデバイスのコンセプトを実機化しました。
「AIを何に入れるか」ではなく、「AIとどう世界を共有するか」から考える。
モバイル機器やスマートデバイスを企画・販売する新興コンシューマーエレクトロニクス企業。生成AIが急速に生活へ入り始めるなか、既存製品へAI機能を追加するだけではない、次のパーソナルデバイスの可能性を探っていました。
スマートフォンには高度なAIが入る一方、利用するときには端末を取り出し、カメラを向け、画面を操作し、自分が置かれている状況をAIへ説明する必要があります。イヤホンなら音声で対話できますが、AIにはユーザーが見ているものまでは伝わりません。
そこでテーマにしたのが、AIと人の接点そのものを、スマートフォンの外へ広げることでした。
服やバッグに装着できるほど小さなデバイスにカメラとマイクを持たせ、目の前の状況と声をスマートフォン経由でAIへ渡す。商品仕様を先に決めるのではなく、まず日常のなかで成立する新しいAI体験を実物から探りました。
AI機能を増やすのではなく、人とAIが同じ状況を共有できるようにする。
今回の出発点は、生成AIを搭載した新製品をつくることではありませんでした。
AIそのものは、すでにスマートフォンやクラウド上にあります。必要だったのは、新しいAIモデルを開発することよりも、ユーザーが見ているものや、その場で起きていることを、AIも同じ文脈として受け取れる状態をつくることでした。
人は、目の前にあるもの、周囲の音、その直前に起きたことを、一つの状況として自然に理解しています。
一方、AIを使うときは、その状況を人があらためて伝えなければなりません。スマートフォンを取り出し、カメラを向け、対象を指定し、何が起きているのかを説明する必要があります。
その距離を、小さなハードウェアから縮めることにしました。
AIは賢くなっても、人と同じ状況を共有しているわけではない。
音声AIは会話できます。カメラ付きのスマートフォンは画像を理解できます。マルチモーダルAIは映像と音声を同時に扱えます。
それぞれの技術はすでに存在しています。
一方で日常利用では、それらをユーザー自身が毎回呼び出し、対象を指定し、状況を説明する必要があります。
人どうしなら、同じ場所で同じものを見ているだけで、「これ」「さっき」「次」といった短い言葉でも意味が通じます。AIとの間には、まだその共有された前提がありません。
必要だったのは新しい要素技術ではなく、既存技術を一つにつなぎ、人とAIが同じ状況を共有できる体験へ組み直すことでした。
いつでもそばにある。だから、説明しなくても伝わる。
デバイスは常時携帯・装着できるサイズを目指しました。
身につけたまま、ユーザーが見ているものと、その場の音を、そのままAIへ渡せる。対象を撮り直したり、状況を言葉にし直したりする手順を挟まない構成です。
同時に、利用状態が外からも分かるようにし、必要のないときは物理的にカメラを閉じられるようにしました。
便利さだけではなく、日常へ持ち込める距離感まで含めて設計します。
そのうえで、重い通信やAI処理はスマートフォン側を活用し、身につけるデバイス自体はできるだけ小さく、軽く、単純にする構成としました。
体験から考え、小さくまとめ、AIまでつなぐ。新しいデバイスカテゴリーを実物から探る。
コンセプト資料だけを作るのではなく、実際に身につけて使えるサイズまでハードウェアを組み、スマートフォンアプリ、通信、画像・音声入力、マルチモーダルAIまでを一つにつなぎました。日常の複数シーンで使える状態をつくることで、新しいパーソナルAIデバイスの成立条件を具体化しています。
AIを入れる箱ではなく、AIとの新しい接点から構想する。
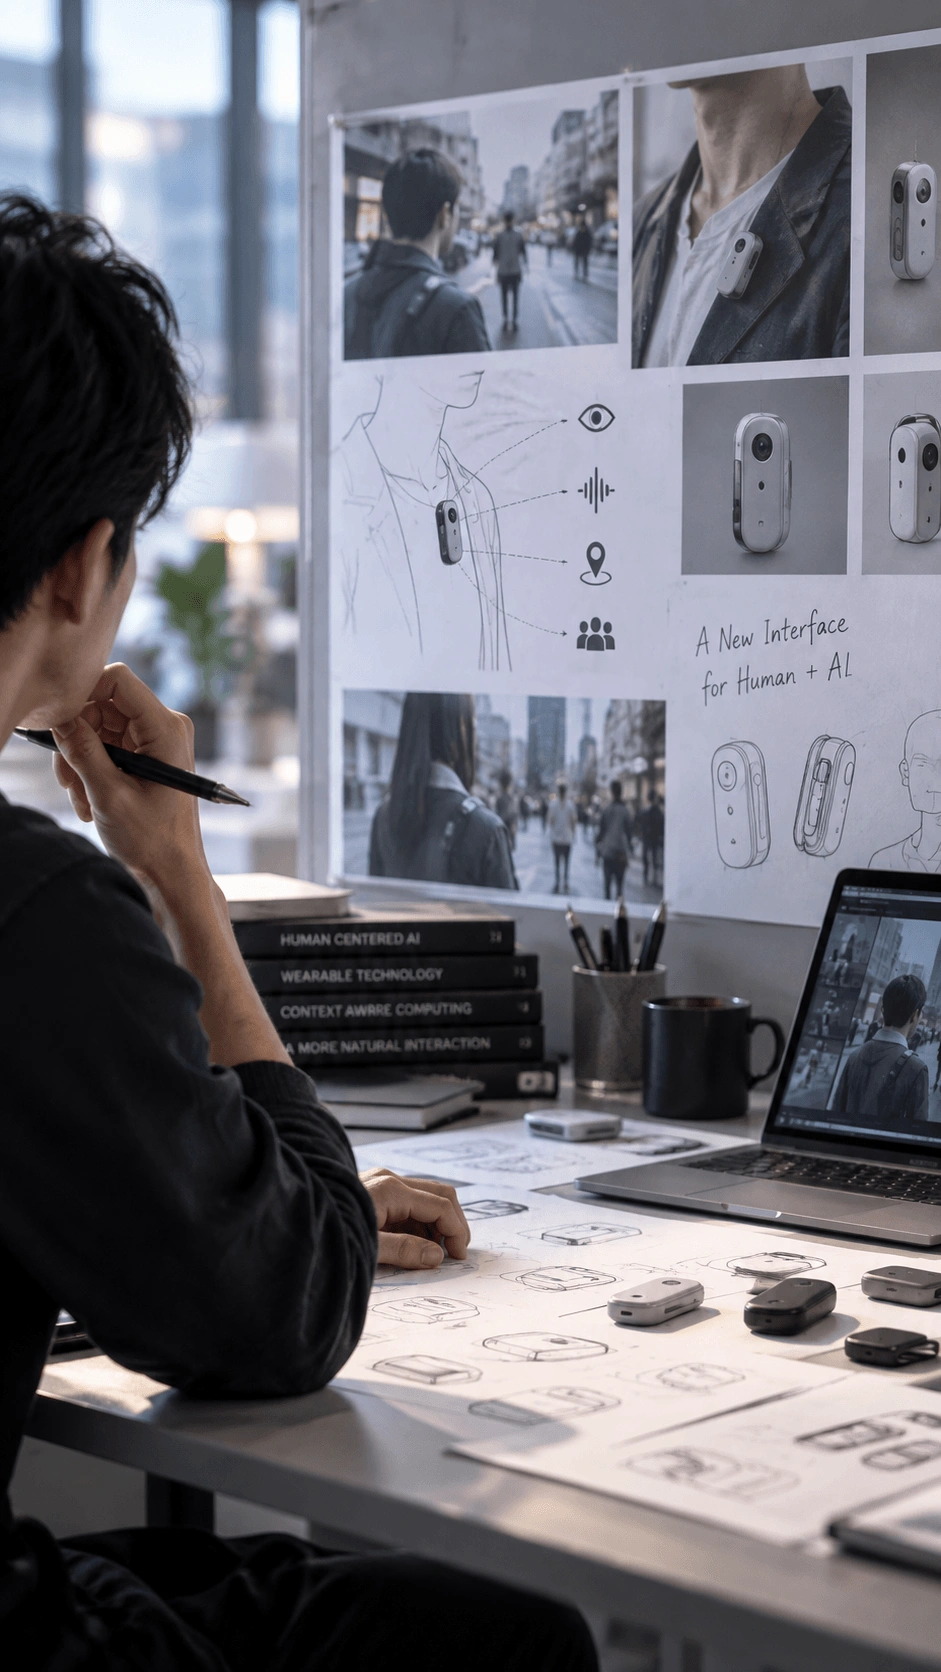
最初に考えたのは、デバイスの形ではありません。
生成AIを使うときに、人はなぜスマートフォンを取り出すのか。なぜカメラを起動するのか。なぜ目の前の状況を言葉で説明し直す必要があるのか。
利用シーンを分解すると、AIの能力よりも、その能力へ到達するまでの操作にまだ余白がありました。
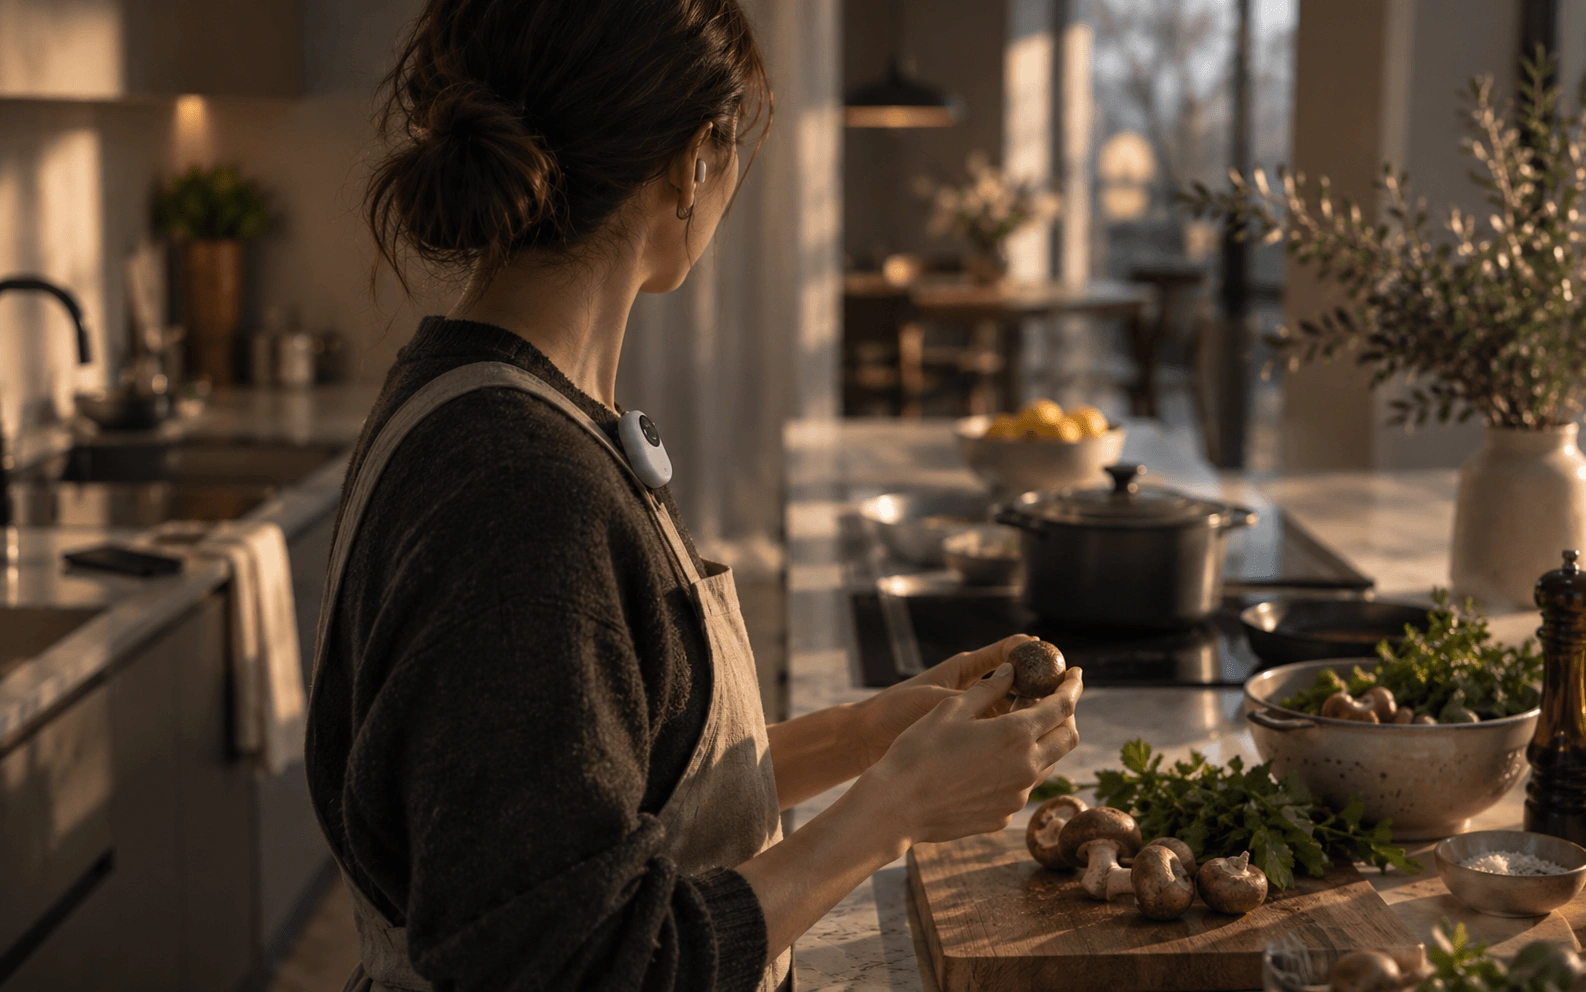
そこで、旅行先の看板、店頭の商品、家電の操作、料理中の食材、気になったもののメモなど、今見ているものをそのままAIへ渡せたら便利な場面から体験を組み立てました。
その体験を起点に、小型カメラとマイクを持ち歩くというデバイスコンセプトへ落としています。
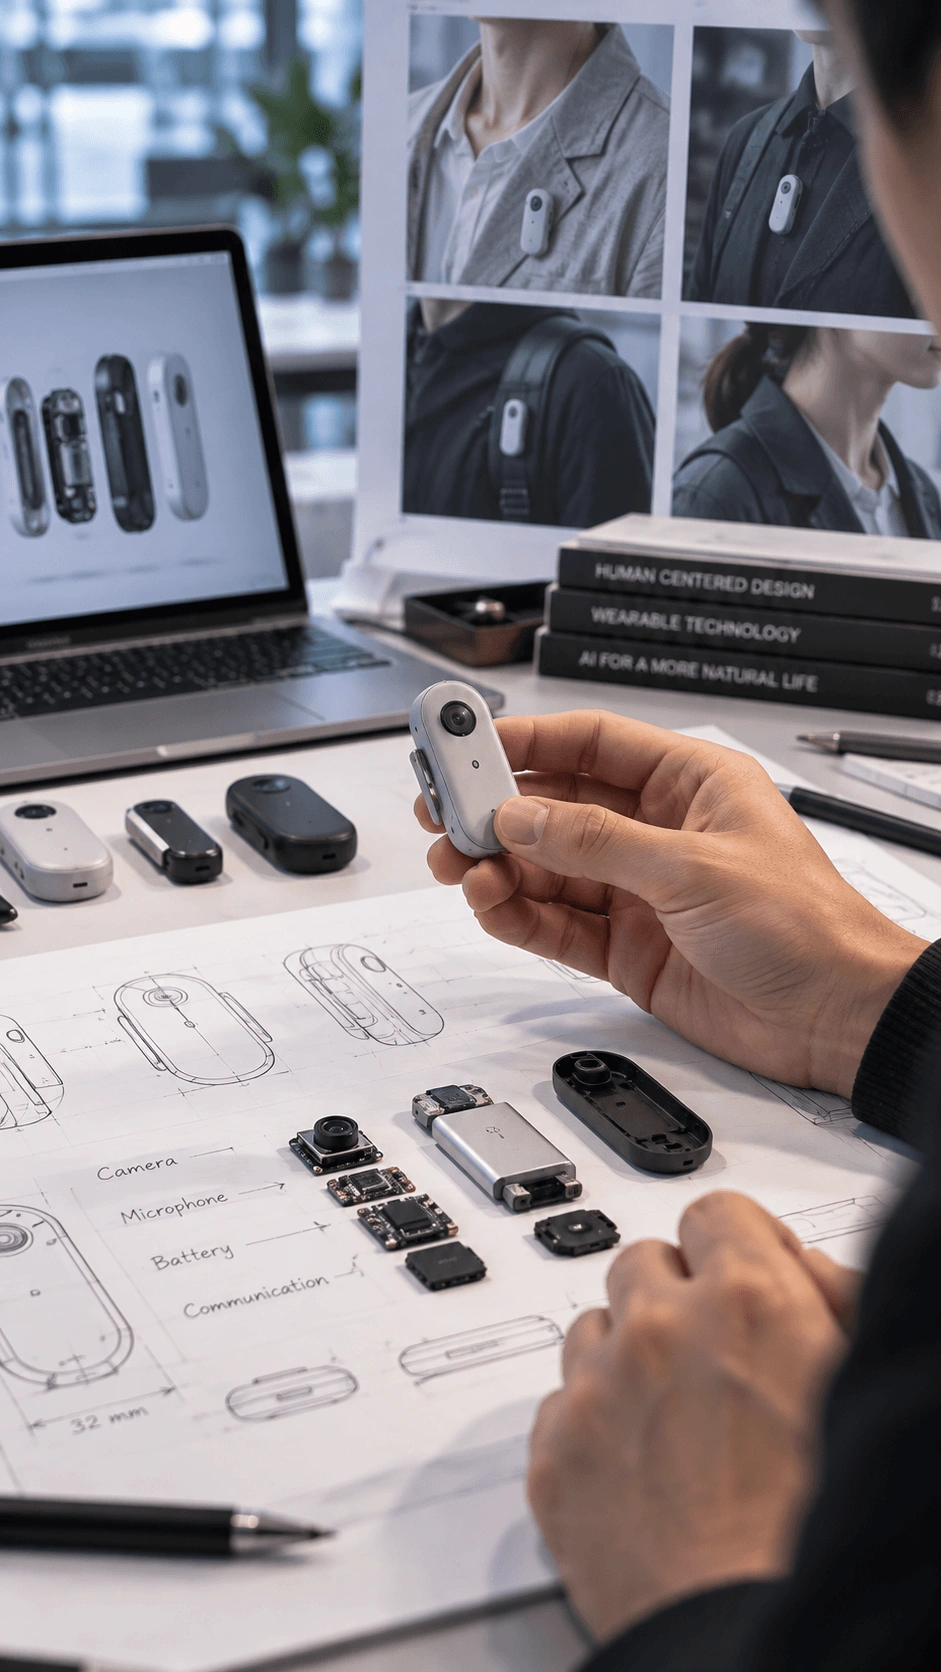
身につけられるサイズへ、カメラ・マイク・電源・通信をまとめる。
体験が成立しても、大きく重いデバイスでは日常へ入りません。
小型カメラ、マイク、操作ボタン、インジケーター、バッテリー、Bluetooth / Wi-Fiなど、必要な要素を選び、衣服やバッグへ装着できるサイズへまとめました。
すべての処理を本体へ持たせるのではなく、通信、位置情報、アカウント、AI処理などはスマートフォン側を活用します。
身につける側は軽く、すでに持っているスマートフォンを計算・通信の基盤として使う。
既存技術を役割分担させることで、未来のコンセプトを現在のハードウェアで成立させました。
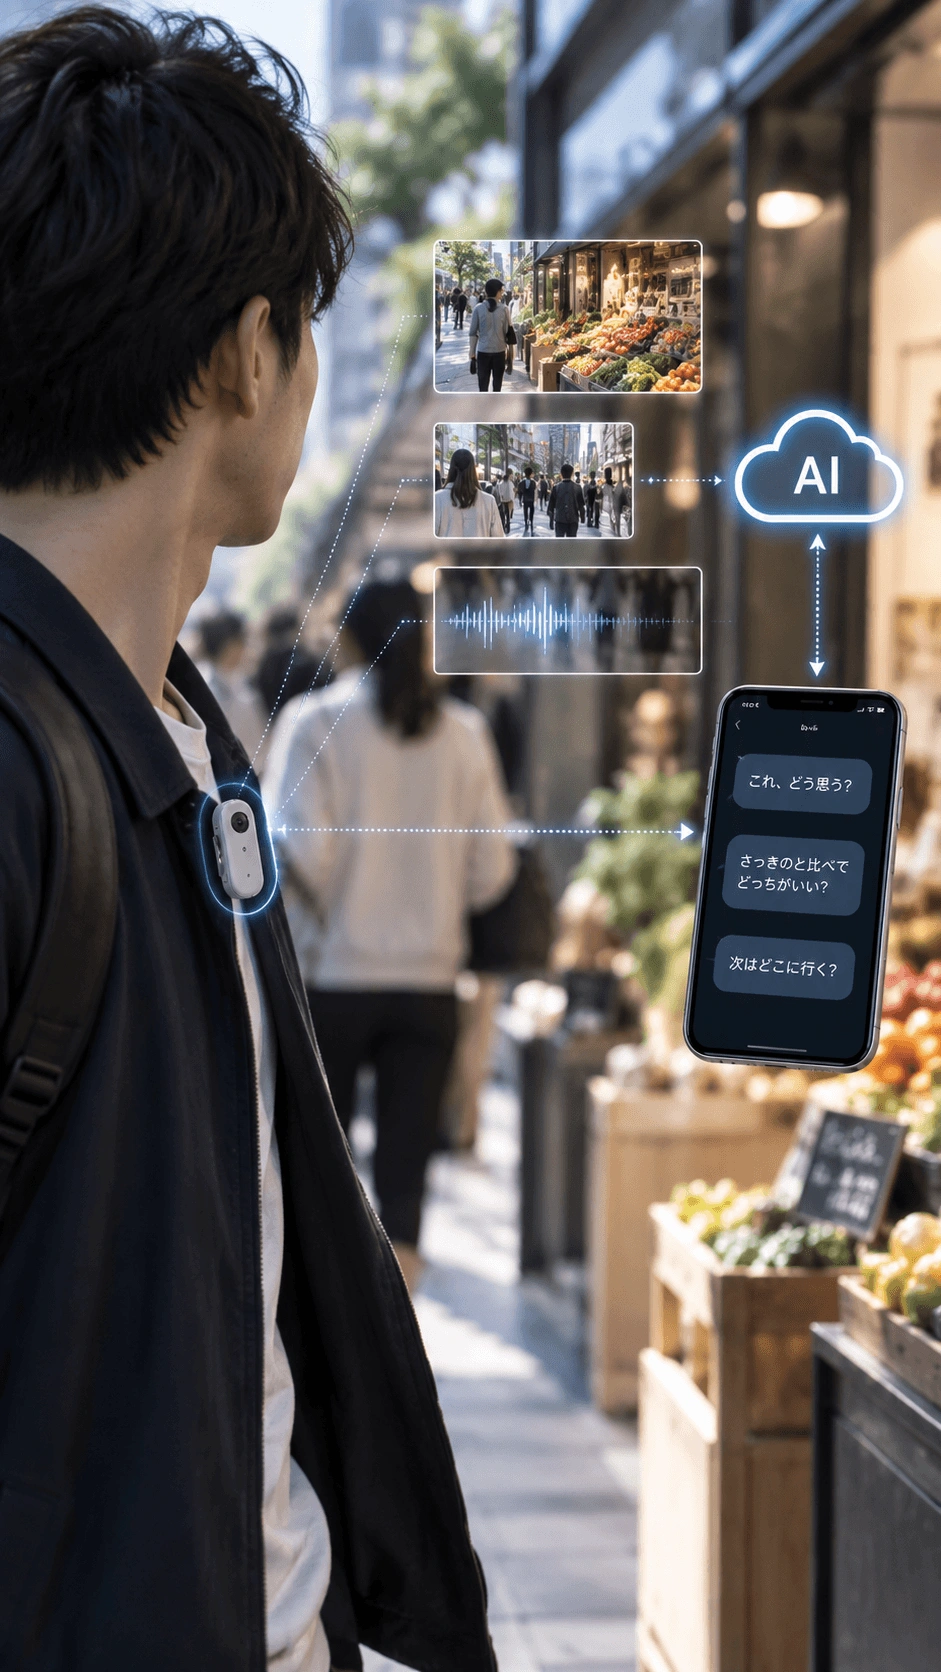
AIと同じ状況を共有し、「これ」「さっき」「次」が通じる対話をつくる。
デバイスが取得する映像と音声をスマートフォンへ送り、マルチモーダルAIへ接続するアプリケーションを構築しました。
重要なのは、質問するたびに一枚の画像を撮影してAIへ渡すことではありません。
ユーザーが見ているものや、その場の音をAIと共有することで、店頭の商品を見ながら「これは何?」、旅先を歩きながら「こっちで合ってる?」、作業を続けながら「次は?」といった短い言葉でも、その場の文脈と合わせてAIへ伝えられるようにします。
ユーザーが対象や状況を毎回一から説明するのではなく、AIも同じ状況を共有した状態から対話を始められるようにしました。
回答はスマートフォン画面だけに限定せず、イヤホンなど既存の出力デバイスとも組み合わせられる構成にしました。
新しいAIを開発するのではなく、映像、音声、通信、アプリ、AIを一本につなぎ、人とAIが同じ世界を共有する一つの利用体験へまとめています。
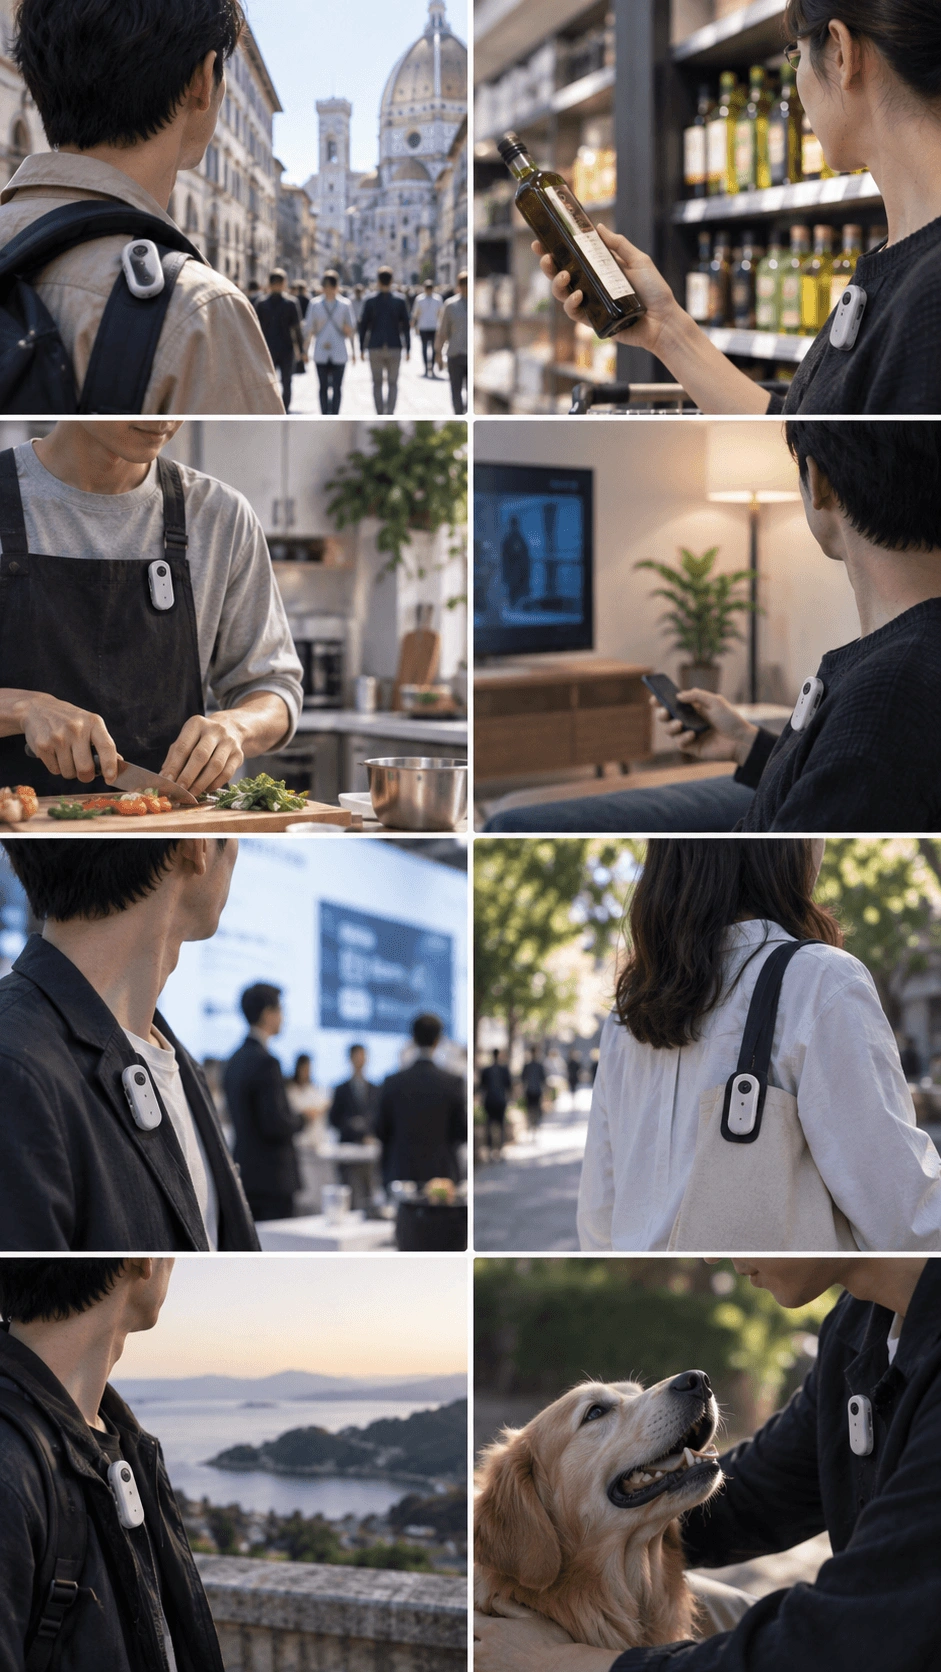
一つの用途に決めず、日常の複数シーンで使ってみる。
プロトタイプを一つの専用製品として固定しませんでした。
旅行、買い物、料理、家電操作、展示会でのメモなど、異なる生活シーンを用意し、同じデバイスを実際に装着して使います。
そこで確認するのはAIの回答精度だけではありません。
どこへ装着すると自然か。どんな操作なら迷わないか。カメラを使っていることをどう伝えるか。どの情報を音声で返し、どこからスマートフォン画面を使うべきか。
利用シーンを変えながらハードウェアとソフトウェアを更新し、一つの商品仕様ではなく、次の商品カテゴリーを成立させるためのR&D資産へ育てました。
この事例で組んだ専門性とフェーズ
AIコンセプトだけでも、ウェアラブル端末の試作だけでもありません。次世代の利用体験から商品コンセプトを組み立て、小型デバイス、通信、スマートフォンアプリ、マルチモーダルAI、装着方法、プライバシーを含むインタラクションまでを一つのプロトタイプとして統合しました。
生成AI時代のパーソナルデバイス構想、利用シナリオ、UX・インタラクション設計、小型カメラ・マイク・通信・電源を含むハードウェア構成、装着方法と筐体試作、スマートフォンアプリ、画像・音声入力、マルチモーダルAI連携、イヤホンなど既存デバイスとの連携、利用状態の表示や物理シャッターを含むプライバシー設計、複数の生活シーンを使った実機アップデートまでを横断した範囲です。
AIが、画面を開いて使うものから、人のそばで同じ世界を共有する存在へ近づく。
生成AIそのものを開発するのではなく、カメラ、マイク、スマートフォン、通信、AIを一つの携帯体験としてつなぎました。ユーザーがその都度状況を説明するのではなく、見ているものやその場の音をAIと共有した状態から対話を始められる。既存カテゴリーの延長だけでは見えにくかった、次世代パーソナルAIデバイスの具体的な形を、実際に身につけて使えるプロトタイプとして提示しています。
まだ製品になっていない未来からでも、実機にできます。
新しいAI、センサー、通信、デバイス技術を、既存カテゴリーへそのまま当てはめる必要はありません。利用する人の体験から商品コンセプトを組み立て、ハードウェア、UI、アプリ、通信、AIまで横断して、実際に使えるプロトタイプへ具体化します。